Meta amplia parceria com AMD em sistemas Helios
A Meta começou a implantar sistemas AMD Helios em escala de rack em sua infraestrutura, aprofundando uma parceria que reúne CPUs EPYC, GPUs Instinct e otimizações de software para inteligência artificial. O acordo inclui suporte aos modelos Muse Spark Open e Muse Glimmer, além de recursos para o agente Muse.
A colaboração abrange processadores EPYC, GPUs Instinct e otimização de software aberto, com implantação em escala de gigawatts voltada à era da superinteligência.
Lisa Su, presidente do conselho e CEO da AMD, descreveu a Meta como uma parceira estratégica com anos de colaboração técnica. Segundo ela, o trabalho conjunto já envolvia processadores EPYC, aceleradores Instinct e software aberto, e agora se expande para o desenvolvimento de silício, software e sistemas destinados aos modelos mais ambiciosos da empresa.
EPYC Venice sustenta a infraestrutura do agente Muse
De acordo com as informações divulgadas, os processadores EPYC formam parte da base do agente pessoal Muse. A Meta já implantou milhões de CPUs da família em diferentes gerações e é apontada como cliente líder dos EPYC Venice, de 6ª geração, baseados na arquitetura Zen 6.
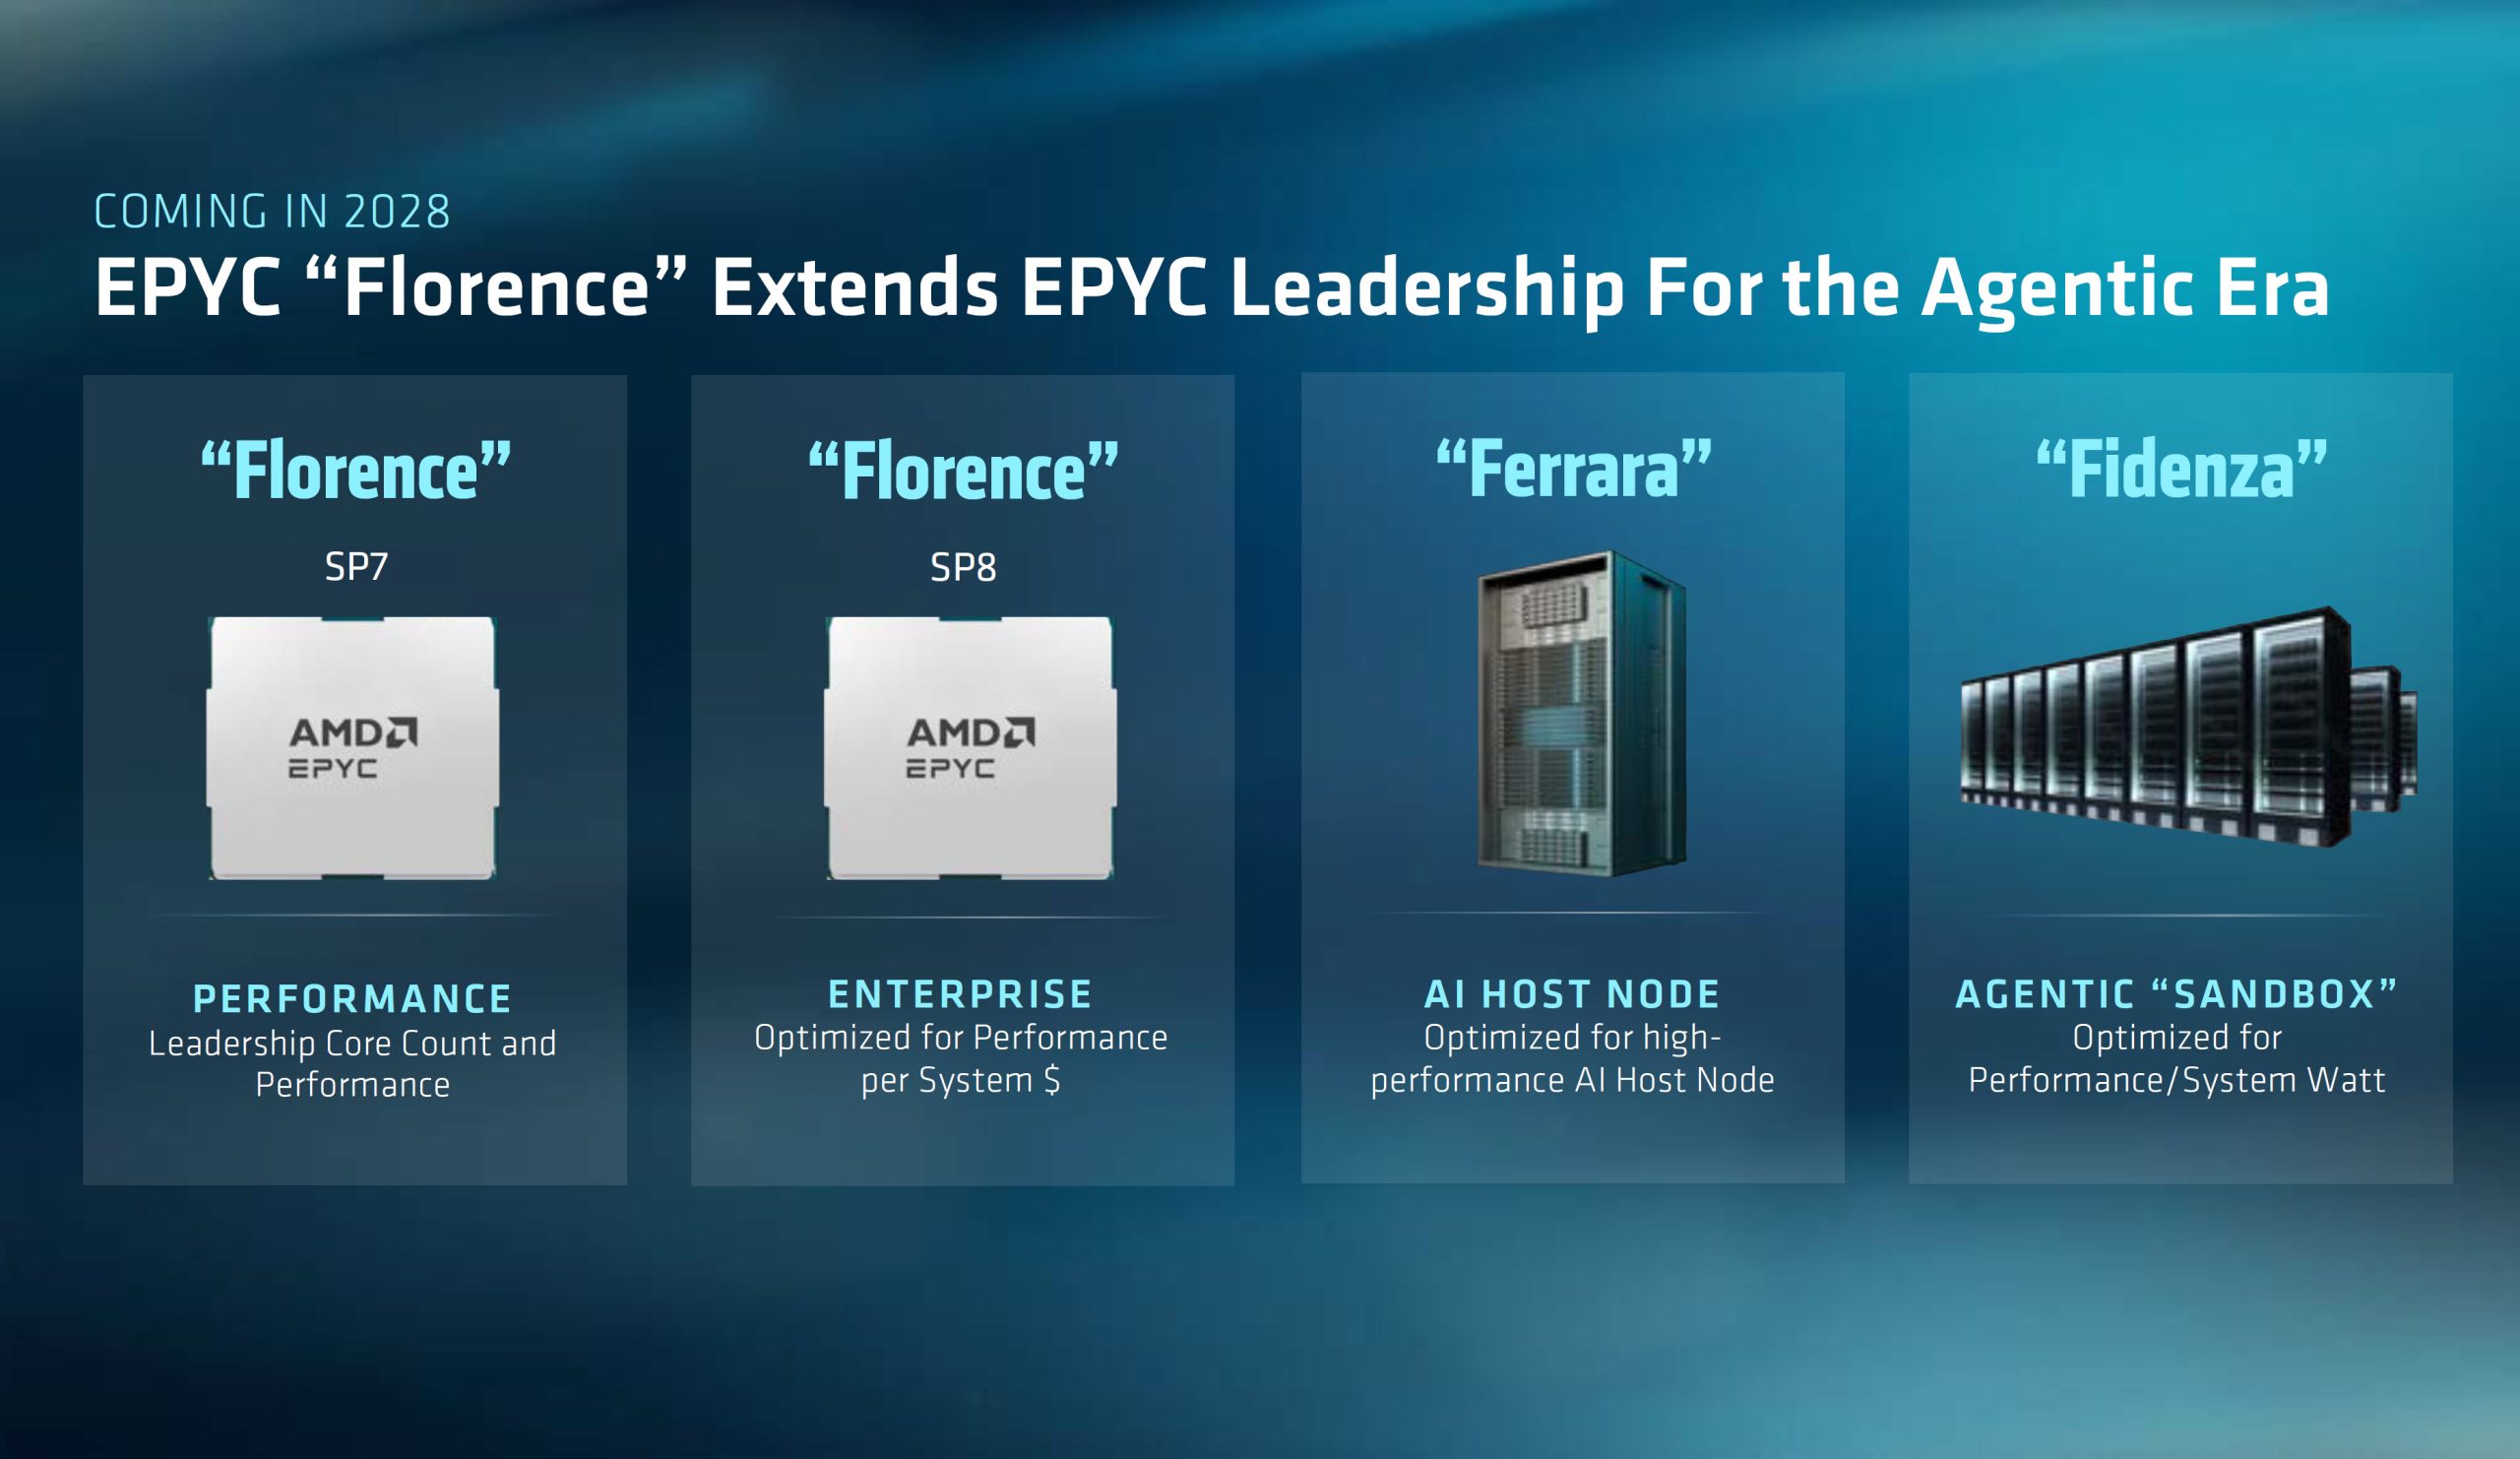
A colaboração também abrange processadores futuros. Um dos projetos citados é o Verano, desenvolvido para cargas de trabalho de IA agêntica; uma apresentação da AMD também projeta o EPYC Florence para 2028, com variantes identificadas como Florence SP7 e SP8.
O material associa o Florence a aplicações descritas como nó de host de IA Ferrara e sandbox agêntico Fidenza. Essas referências aparecem como parte de uma projeção da AMD, não como confirmação de que os processadores já estejam disponíveis.
Instinct MI450 e aceleradores feitos para a Meta
No lado das GPUs, a Meta utiliza aceleradores Instinct em tarefas de treinamento, ranking e recomendação. A empresa também é cliente de definição inicial da série MI450 e planeja implantar uma GPU Instinct personalizada, ajustada às próprias cargas de trabalho.
A parceria inclui ainda futuras plataformas Instinct MI500 e sistemas de próxima geração em escala de rack. A infraestrutura da Meta combina GPUs AMD, GPUs NVIDIA e aceleradores proprietários MTIA, uma composição que permite distribuir diferentes tarefas entre fornecedores e tecnologias.
O texto de origem aponta que o histórico de otimizações da Meta para GPUs NVIDIA pode dificultar a transferência direta de desempenho para outros hardwares. Por isso, a colaboração em software e no ajuste conjunto entre modelos e aceleradores é parte importante da estratégia descrita.
ROCm e PyTorch aproximam os modelos das GPUs AMD
AMD e Meta ampliaram o trabalho em software para treinamento de IA em larga escala. Entre as iniciativas citadas estão otimizações dos modelos nas GPUs Instinct MI350X e contribuições para PyTorch, Triton e ROCm, conjunto de ferramentas da AMD para computação em GPUs.
Segundo a descrição da parceria, o suporte day-0 permite que o Muse Spark Open seja executado em GPUs Instinct desde o início de sua disponibilização nesse ambiente. O Muse Glimmer também foi associado a PCs com Ryzen AI e a GPUs Radeon.
Os dados apresentados para o Muse Spark Open descrevem um modelo com 816 bilhões de parâmetros no total e 42 bilhões ativos em uma arquitetura MoE, além de contexto de 1 milhão de tokens. A configuração indicada usa um único nó com oito GPUs MI350X, vLLM e os formatos BF16, MXFP4 e FP8.
De acordo com os números divulgados para as otimizações, ajustes de memória e da organização interna dos blocos elevaram a vazão de 206 para 350 tokens por segundo com quatro usuários simultâneos. Com 32 usuários, o indicador passou de 719 para 1.180 tokens por segundo.
Outra técnica, baseada em paralelismo de especialistas entre as GPUs, teria aumentado a vazão em até 20% ao processar de 32 a 128 solicitações simultâneas. O material também aponta redução de 24% no tempo de espera inicial e uma marca de 2.197 tokens por segundo nesse conjunto de testes.
Os dados incluem ainda uma tabela do AITER para encaminhar pequenos lotes diretamente ao processador, sem uma etapa adicional de organização. Com oito GPUs, a velocidade indicada sobe de 98 para 114 tokens por segundo, um ganho de 16%, sem alteração do código.
Já o sistema de previsão do AITER teria alcançado 199 tokens por segundo em uma tarefa, 72% acima do método anterior. O ganho informado diminui conforme aumenta o número de solicitações simultâneas: 47% com duas, 31% com quatro e 6% com 32.
Co-design entre hardware e modelos muda a abordagem
Um documento técnico da Meta compara a Instinct MI350X à NVIDIA B200 em tarefas de treinamento de modelos de recomendação. Em vez de simplesmente transferir modelos de uma GPU para outra, a proposta é revisar estruturas e configurações de software para aproveitar as características específicas de cada acelerador.
Um exemplo citado é a capacidade de memória HBM da MI350X, descrita como 1,6 vez maior que a da B200. O documento também apresenta métodos para estimar o rendimento do sistema e escolher ferramentas de processamento sem depender de testes prévios para cada combinação de arquivos e modelos.
O terceiro princípio mencionado envolve fluxos de trabalho agênticos para facilitar a migração a partir do ecossistema CUDA, com otimizações de kernels adaptadas à microarquitetura e geração de componentes personalizados. Segundo o documento, o conjunto dessas técnicas alcançou até 1,5 vez mais velocidade no treinamento completo em comparação com o sistema original convertido sem alterações.
O que a parceria muda para a infraestrutura de IA
A implantação dos sistemas Helios amplia o espaço da AMD dentro da infraestrutura da Meta, que já combina CPUs EPYC, GPUs Instinct e aceleradores próprios. A integração de hardware com ferramentas abertas também pode reduzir o trabalho necessário para adaptar modelos a diferentes plataformas, embora os resultados descritos se refiram às configurações e aos testes apresentados.
O documento da Meta é apresentado como um relato de uso real de chips gráficos AMD no treinamento de sistemas de grande porte. As melhorias mencionadas foram direcionadas também a projetos de código aberto como PyTorch, Triton e ROCm, o que pode beneficiar outros desenvolvedores que trabalham com essas ferramentas.
O que ainda falta esclarecer
As informações divulgadas não detalham o cronograma completo da implantação dos sistemas Helios nem a escala efetiva de cada etapa. Também não especificam quando a GPU Instinct personalizada será implementada ou como as futuras plataformas MI500 e EPYC Florence serão distribuídas.
Por enquanto, o anúncio mostra uma parceria que vai além da compra de aceleradores: envolve ajustes em modelos, infraestrutura e software para atender às cargas de trabalho da Meta. A questão será acompanhar até que ponto essa integração se traduz em maior flexibilidade entre fornecedores e em ganhos práticos para os serviços de IA da empresa — qual parte dessa estratégia você considera mais decisiva?
Com informações de WCCFtech.

Equipe do Universo Geek News.